Scrape Ondac, traspaso keynotes y assembly codes desde modelo revit a excel
Buscando diseñar un metodo para homologar la info de revit (tablas y modelos) unificando información desde el sistema de clasificación, hasta el presuspuesto oficial y EETT, una opción es el diseño compuesto por los siguientes pasos:
1.- Para prueba tomar un modelo simple con elementos basicos (Fig 1)
2.- Scrape Ondac: Para poder traspasar la info del modelo a un presupuesto se se toma la base de Ondac que contiene las actividades, partidas y tareas a determinar en un presupuesto de obra, Script Python on librerías BeautifulSoup y Request para scrapeo (Script adjunto) (Fig 2)
La idea es tener una base para reemplazar los keynotes nativos de revit, asi tener definición de elementos constructivos, asi como una clasificación de partidas a través de los Assembly Codes. Una vez incorporada esta info en el modelo, tomar el resto de la info en esta lista para linkear las tareas definidas por Ondac a cada partida
4.-Asignaciónde Keynotees y Assembly en Revit (Fig 3)
5.-Lectura de JSON en Dynamo (Archivo Adjunto) (Fig 4)
6.-Traspaso de información de elementos (Keynotes y Assembly Codes) (Fig 5)
7.-Extracción de valores únicos, y traspaso a excel (Fig 6)
8.-Proceso similar para Assembly Codes, los que pueden ser utilizados como guía para la elaboración de las EETT (Fig 7)
9.-Verificación de valores con una categoría distinta (pisos) (Fig 8)
Codigo Ejemplo:
from bs4 import BeautifulSoup
from bs4 import UnicodeDammit
import requests
import json
from collections import defaultdict
import urllib3
import csv
import sys


source = requests.get('https://portal.ondac.com/601/w3-propertyname-503.html').text

sss = source.encode(encoding="ISO-8859-1")

soup = BeautifulSoup(sss, 'html.parser')
soup.encode("utf8")
print(soup.original_encoding)
#print(soup)


lista = soup.find_all('li')
data_json = defaultdict(list)
lista_actividades = {}
links_a = []

ondac_tit = {}

#print(lista)

for lis in soup.find_all('a', attrs={'class':'pnid-503'}):
    act = {}
    titulos = lis.text
    #print(titulos)
    if titulos[1] == '.':
        ondac_tit[titulos] = {}

print(ondac_tit)


for lis in soup.find_all('a', attrs={'class':'pnid-503'}):
    act = {}
    titulos = lis.text
    primera_capa = lis.get('href')
    source_b = requests.get('https://portal.ondac.com/601/{}'.format(primera_capa)).text
    source_b.encode(encoding="ISO-8859-1")
    soup_b = BeautifulSoup(source_b, 'html.parser')
    soup_b.encode("utf8")
    recurso_por_act = []
    for lis_b in soup_b.find_all('a', attrs={'class': 'current'}):
        if lis_b.text[1] != '.':
            segunda_capa = lis_b.get('href')
            print(lis_b)
            source_c = requests.get('https://portal.ondac.com/601/{}'.format(segunda_capa)).text
            source_c.encode(encoding="ISO-8859-1")
            soup_c = BeautifulSoup(source_c, 'html.parser')
            soup_c.encode("utf8")
            tarea = {}
            for lis_c in soup_c.find_all('td', attrs={'class': 'titulo'}):
                print(lis_c)
                tercera_capa = lis_c.find('a').get('href')
                print(tercera_capa)
                source_d = requests.get('https://portal.ondac.com/601/{}'.format(tercera_capa)).text
                source_d.encode(encoding="ISO-8859-1")
                soup_d = BeautifulSoup(source_d, 'html.parser')
                soup_d.encode("utf8")
                partida = []
                for lis_d in soup_d.find_all('a', attrs={'class': 'pnid-505'}):
                    print(lis_d)
                    cuarta_capa = lis_d.get('href')
                    partida.append(lis_d.text)
                if len(partida) > 0:
                    tarea[lis_c.text]=partida
            recurso_por_act.append(tarea)


    if recurso_por_act:
        for keyy in ondac_tit:
            if keyy[0] == titulos[0]:
                ondac_tit[keyy][titulos] = recurso_por_act[0]
    print(ondac_tit)


print(lista_actividades)

exportdict = open('ondac.txt', "w", encoding="UTF-8")
json.dump(ondac_tit, exportdict, ensure_ascii=False)
exportdict.close()
Archivos Anexos
Imagenes
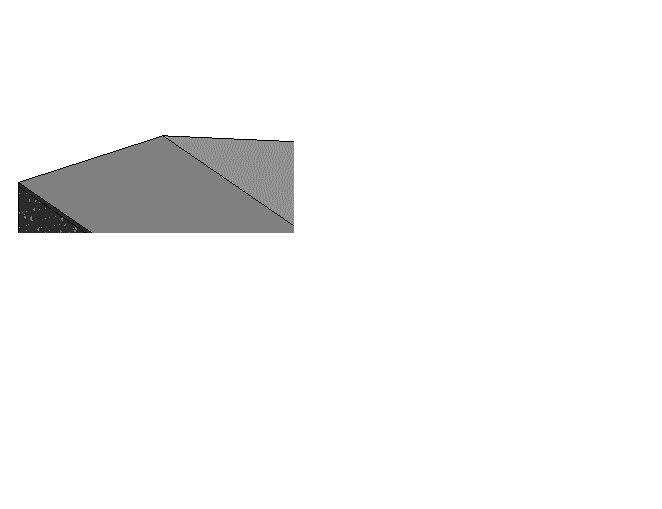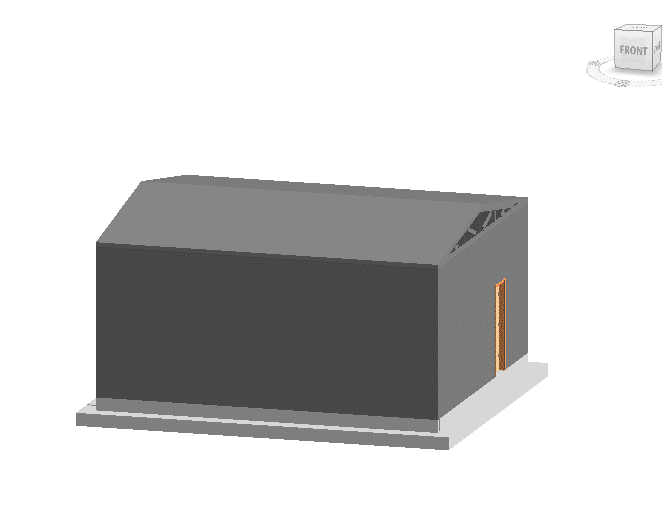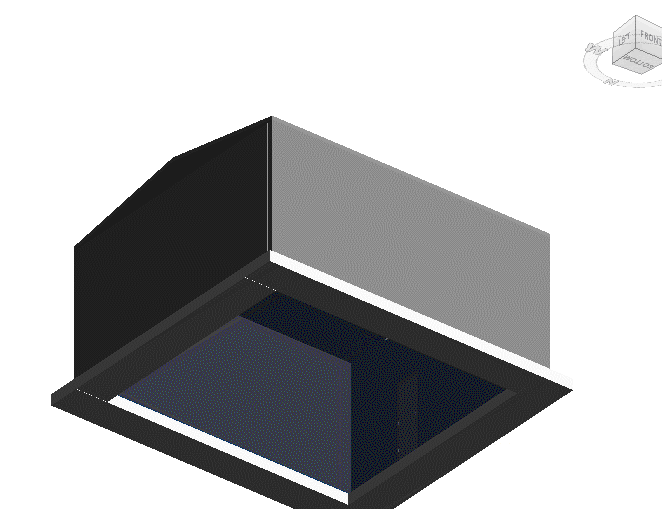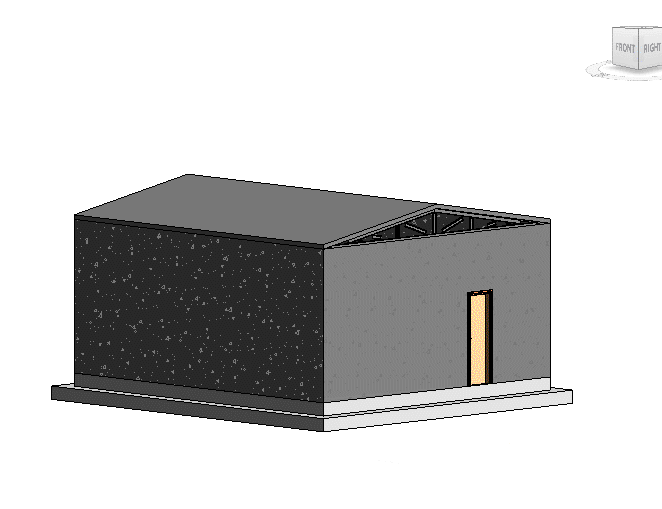
Fig 1
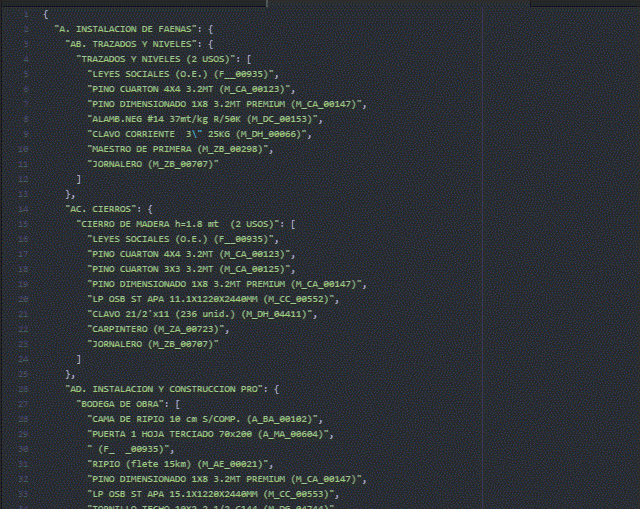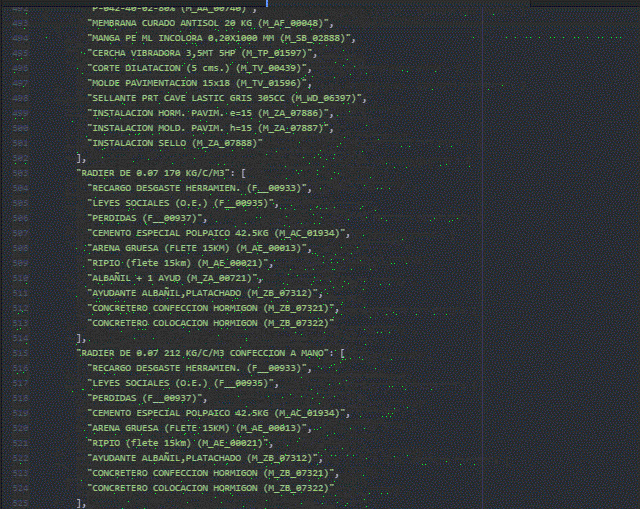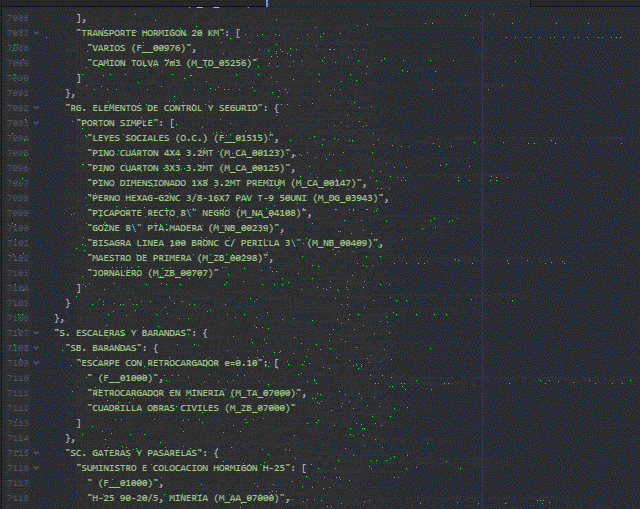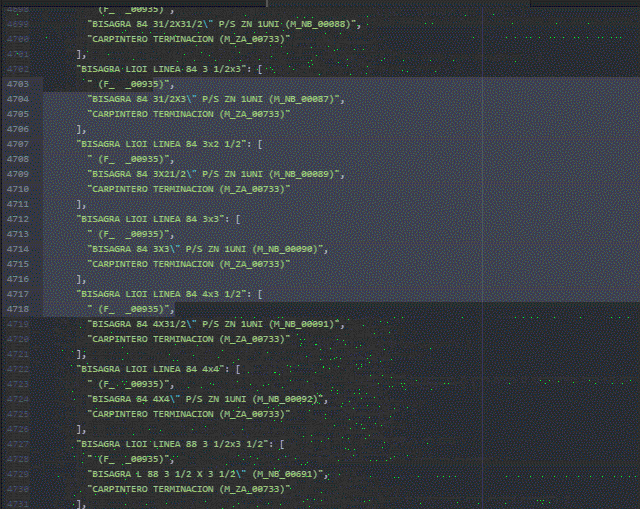
Fig 2
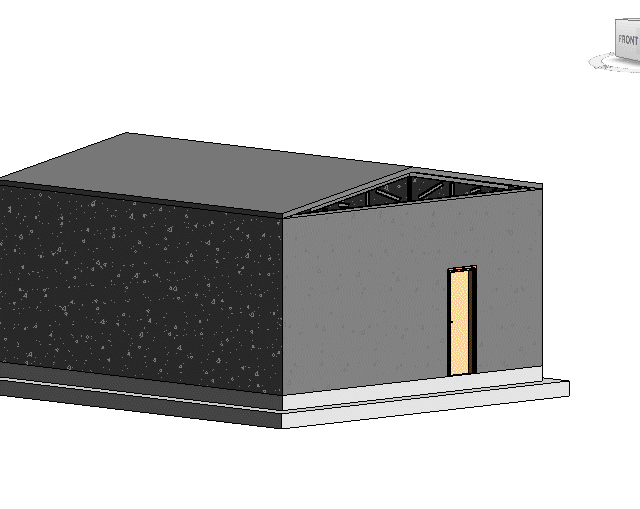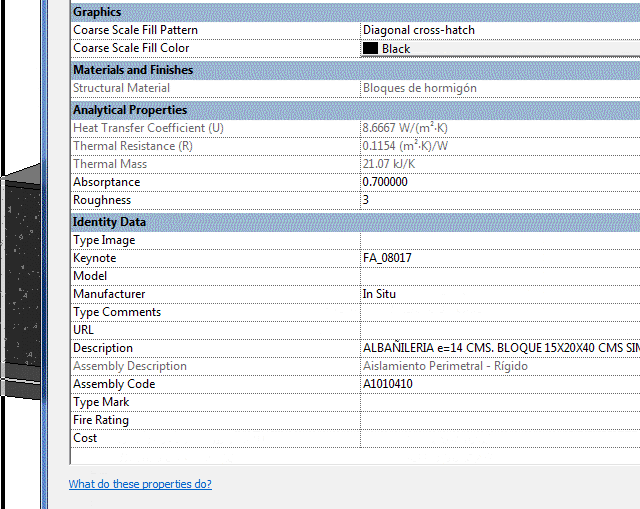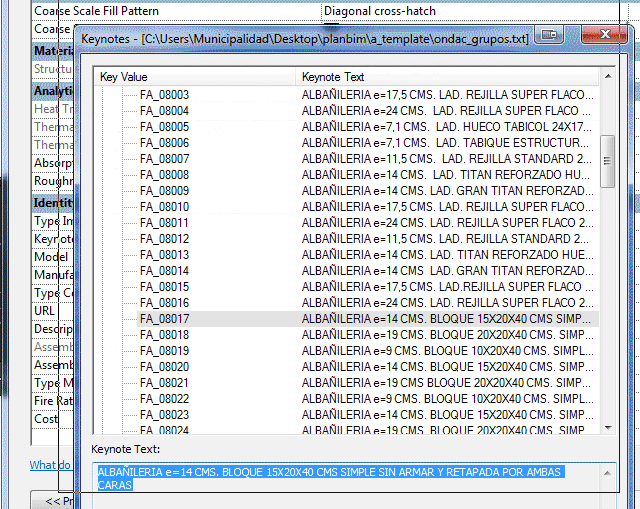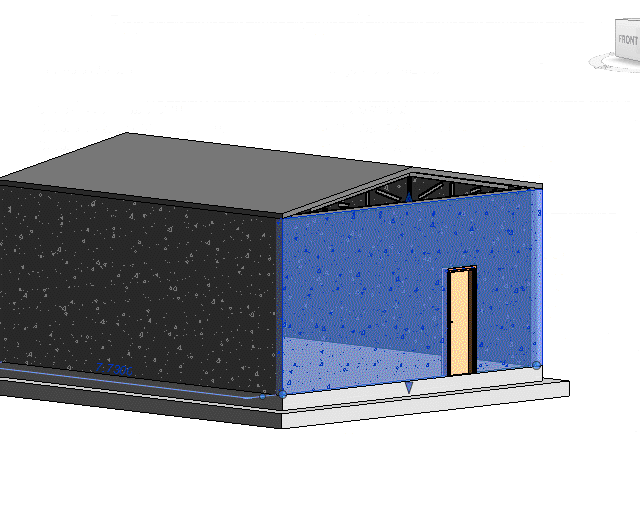
Fig 3
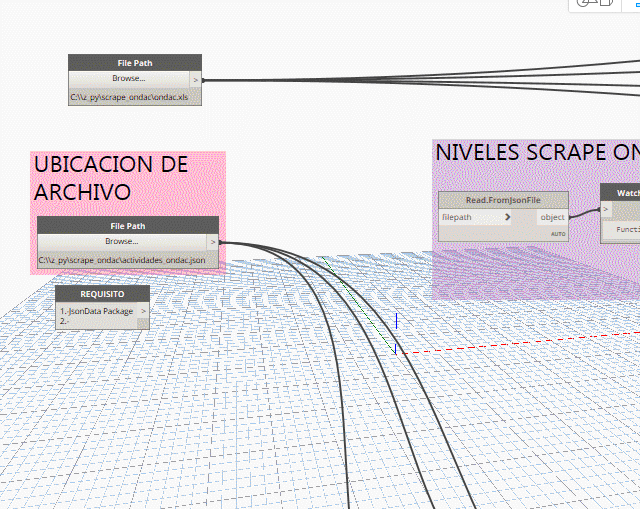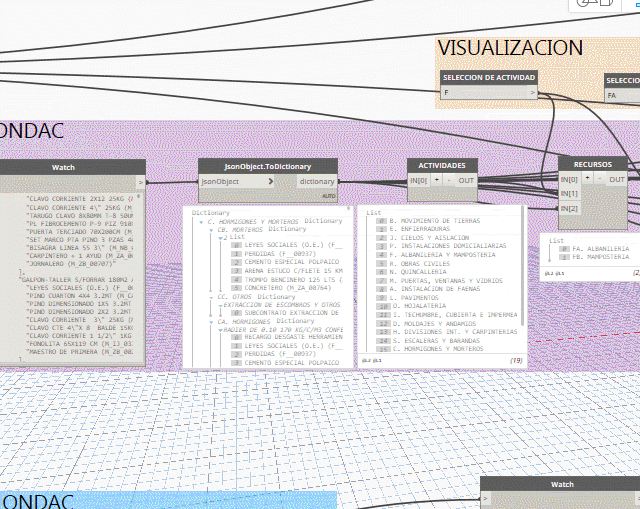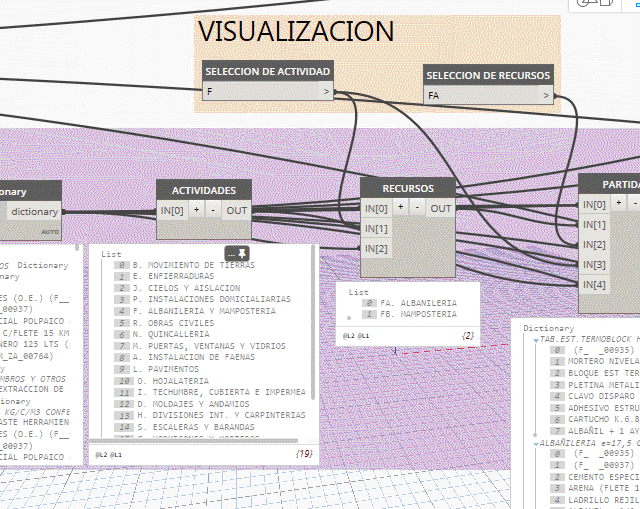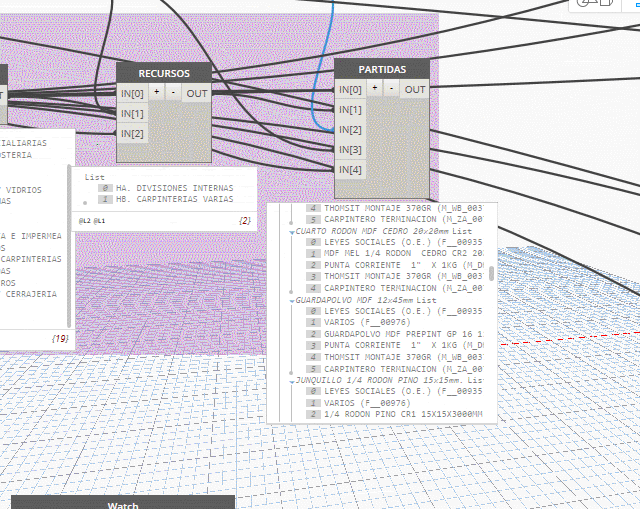
Fig 4
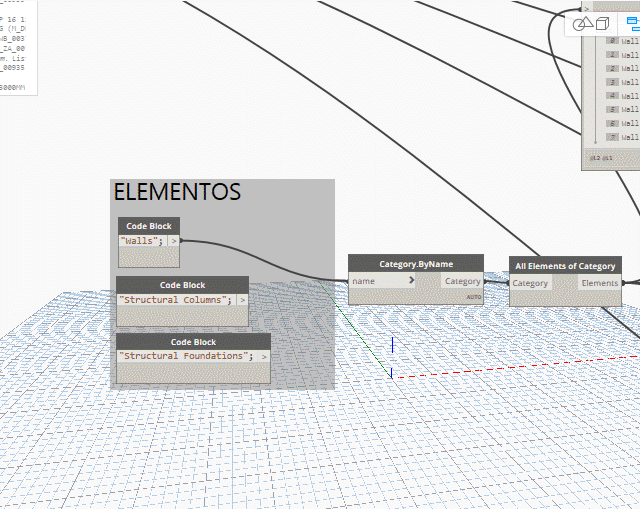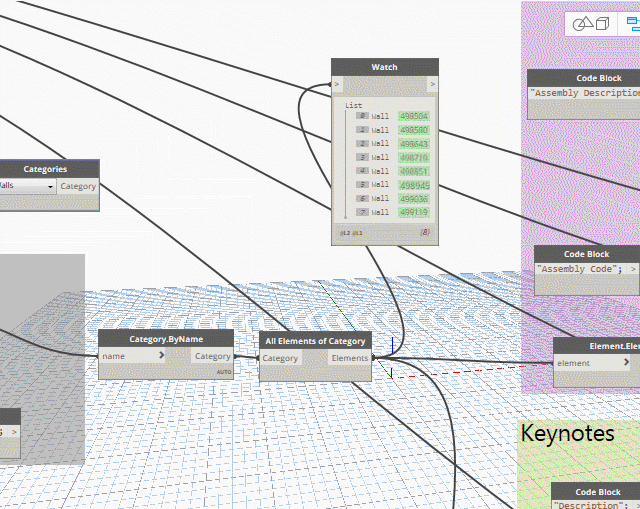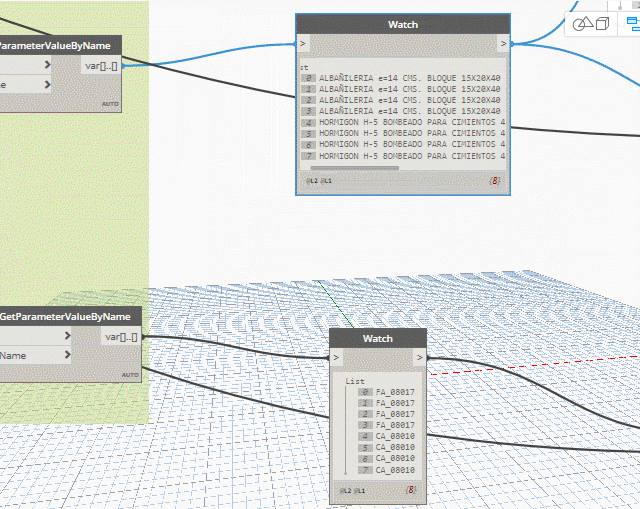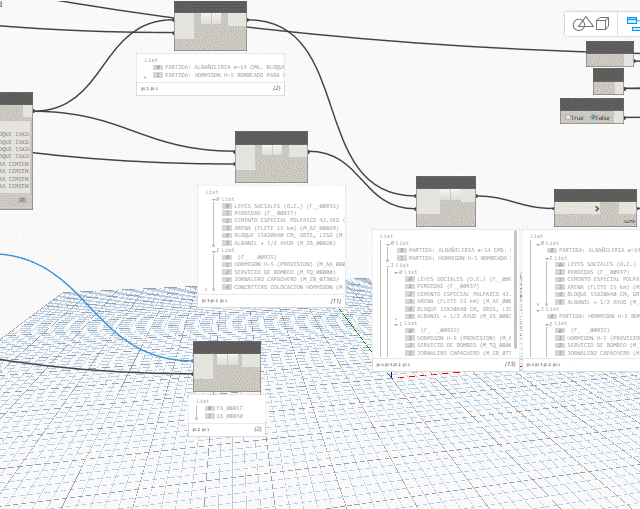
Fig 5
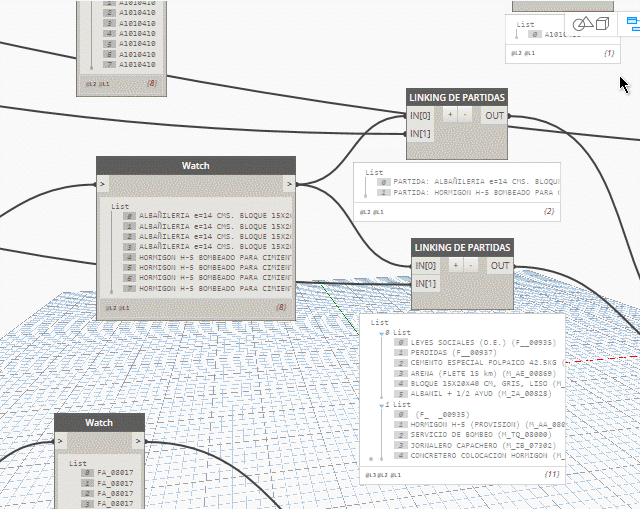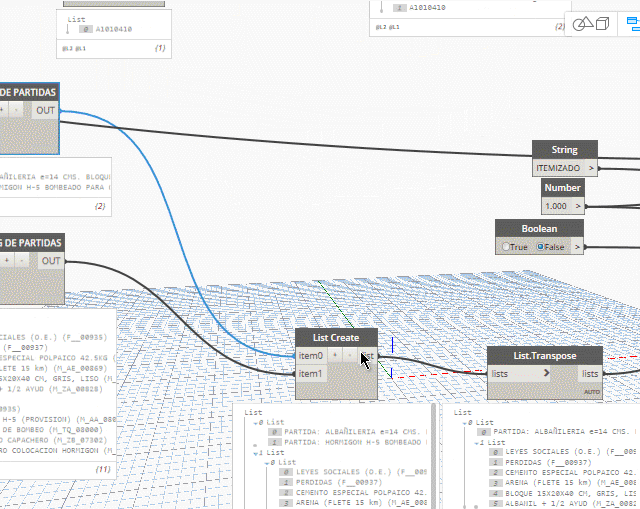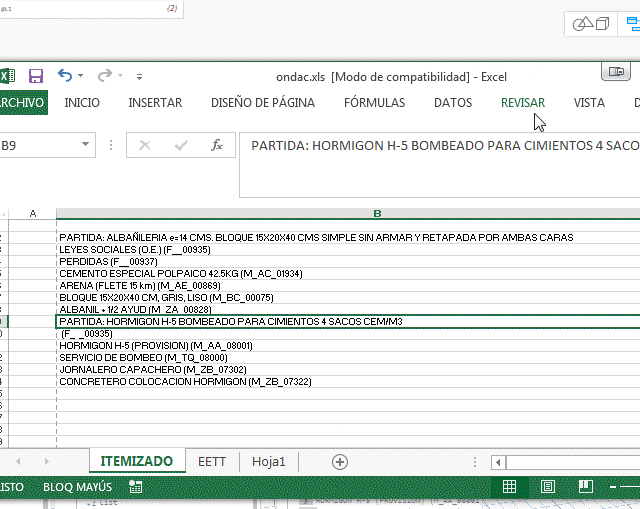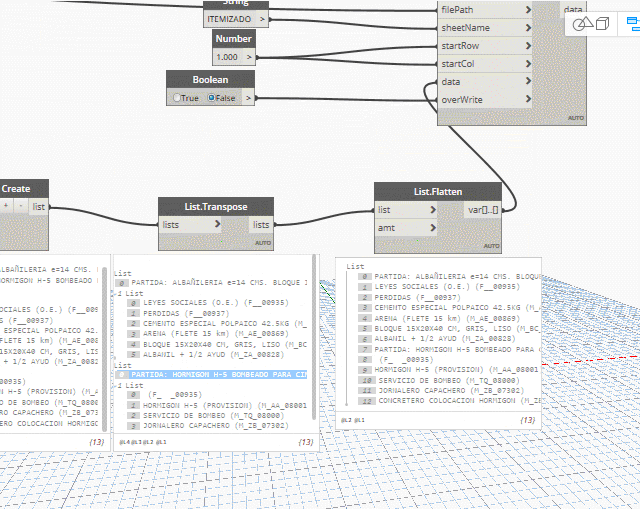
Fig 6
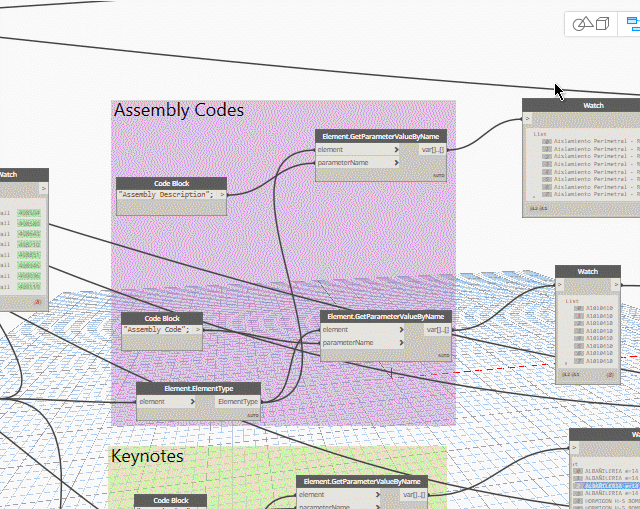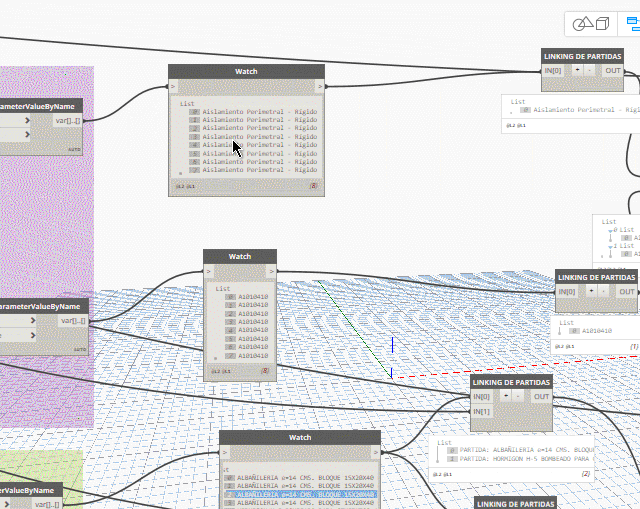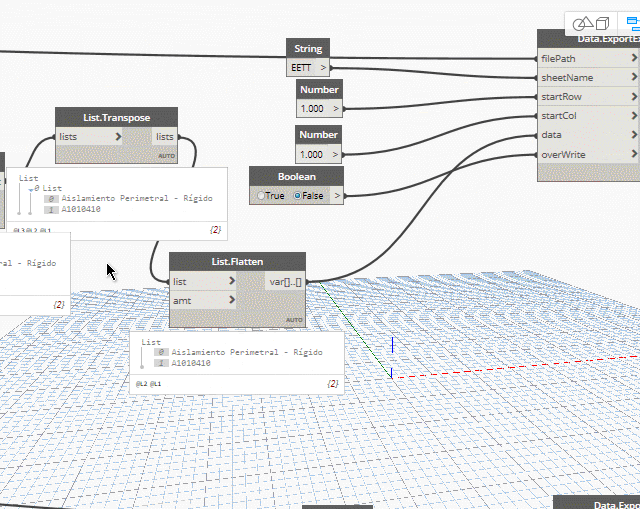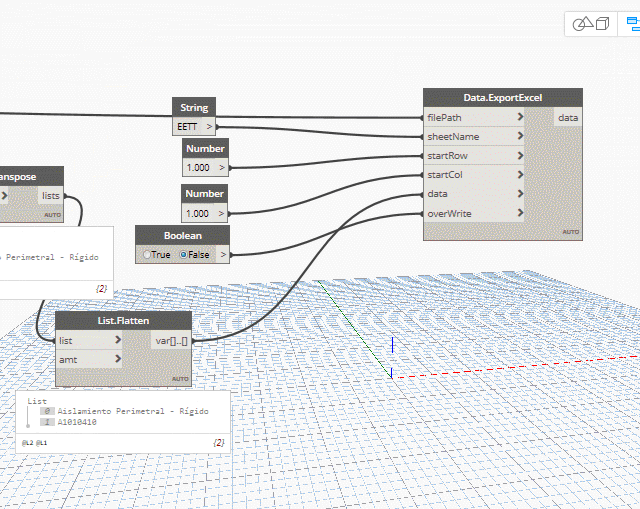
Fig 7
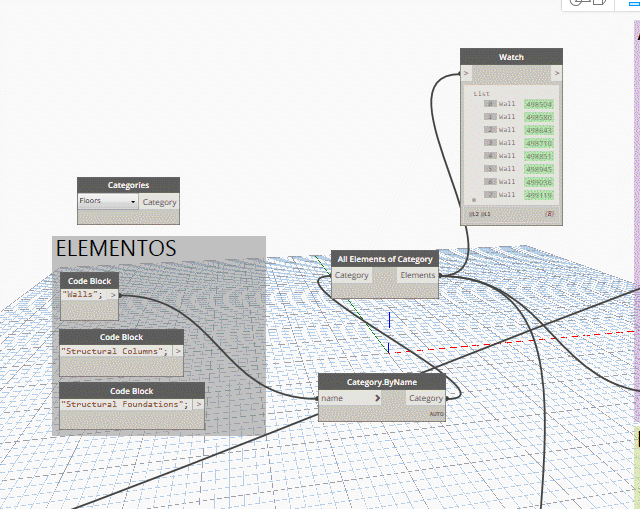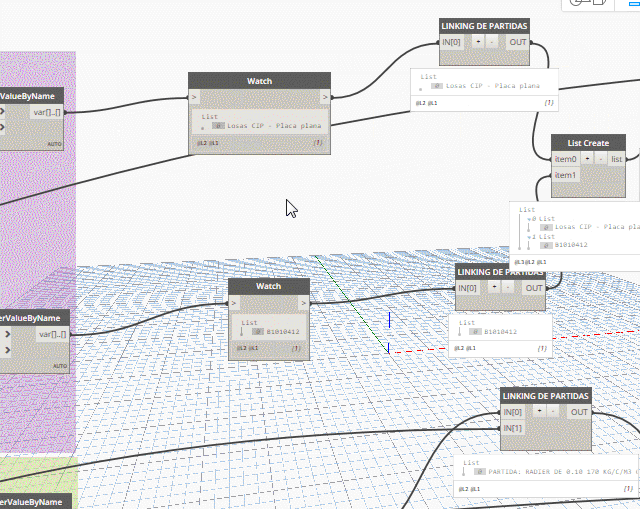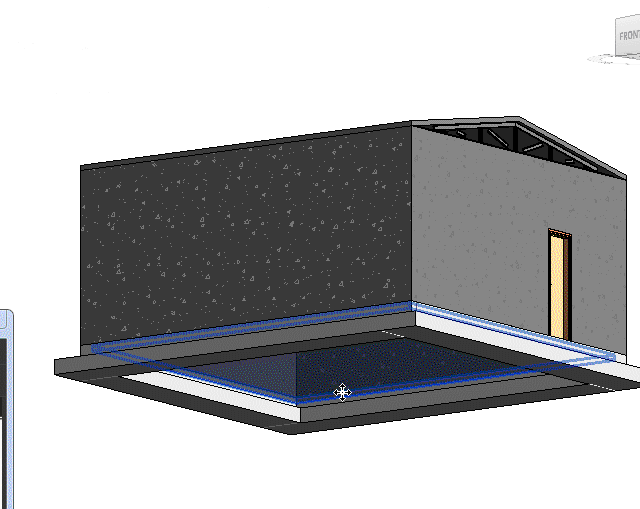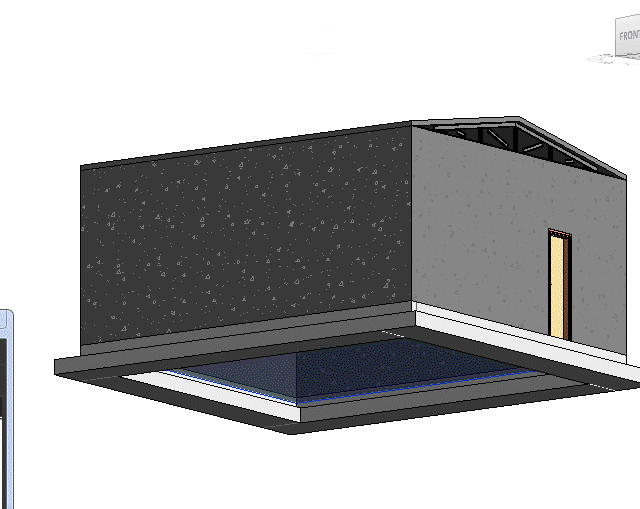
Fig 8
COMENTARIOS
VOLVER